Vue 3.0 源码 (一)
Oct 04, 2021
前言
本篇文章的内容基于 Vue 版本:v3.0.0-rc.5。
Vue 3.0 架构上进行了拆分,使得各模块相互独立。因此,你可以单独将 Vue 3.0 的响应式模块抽离出来独立使用,例如 @vue-reactivity/fs,你也可以基于 runtime-core 自己写一个 renderer 来适配 DOM 以外场景的渲染。
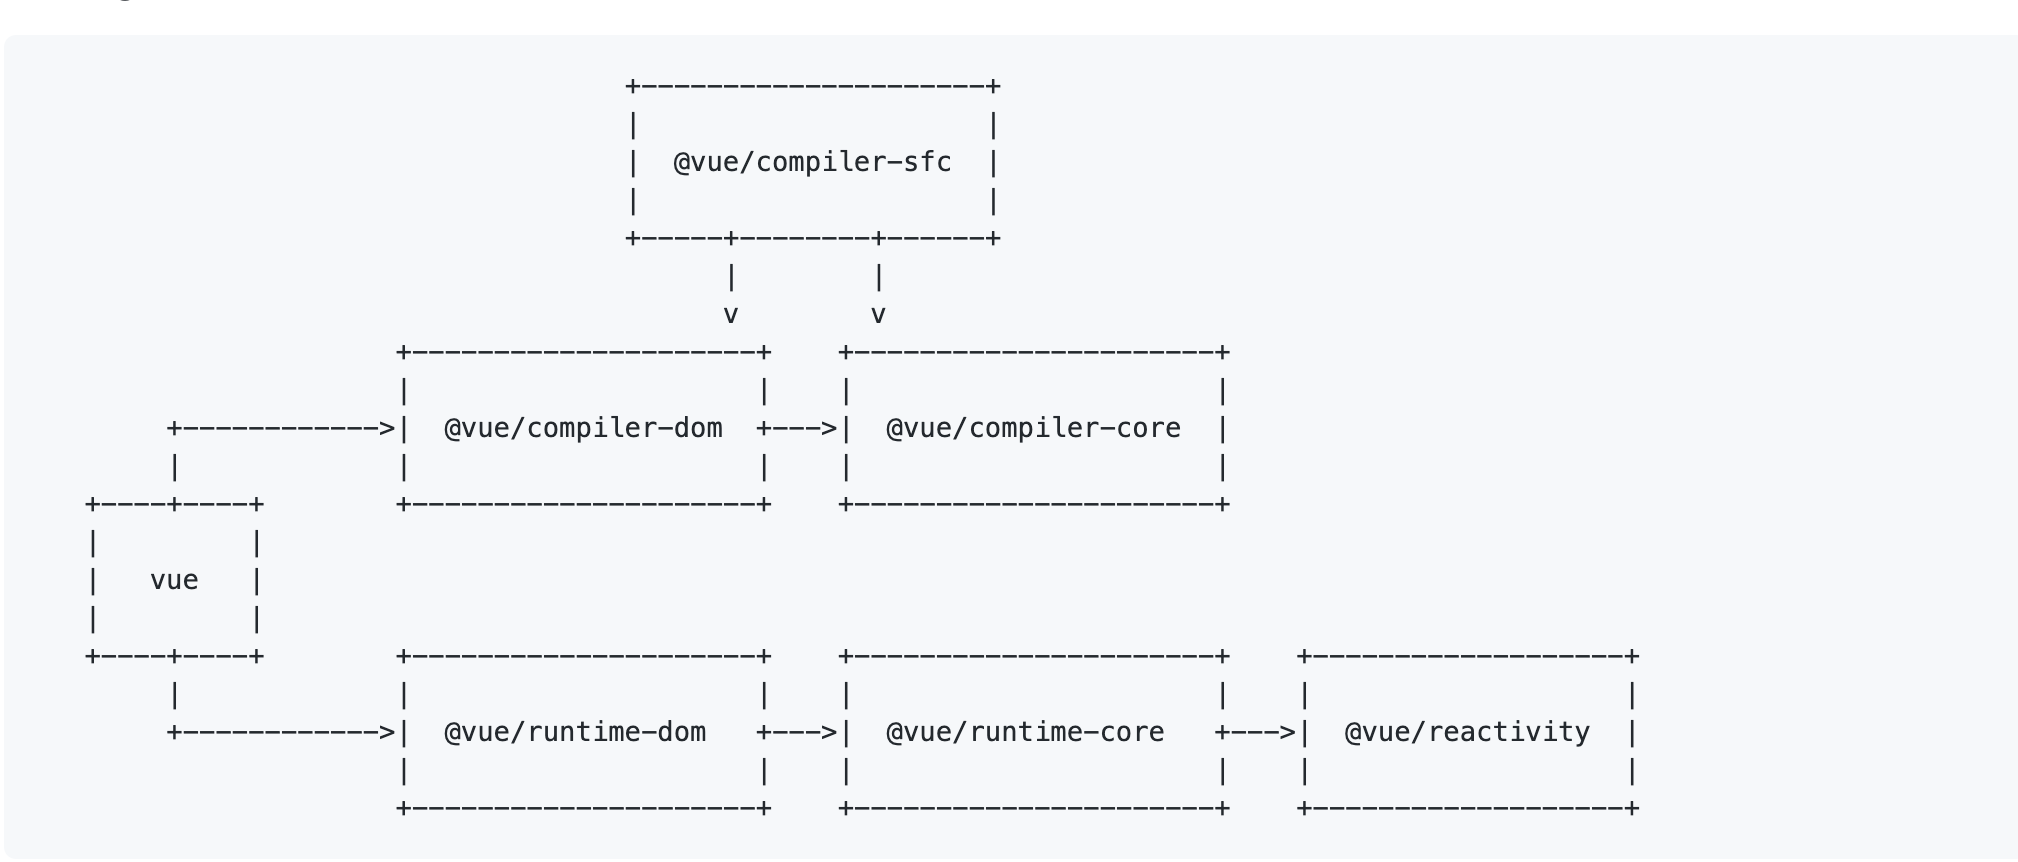
这篇就来讲讲 @vue/reactivity 模块。
文件结构
.
├── baseHandlers.ts
├── collectionHandlers.ts
├── computed.ts
├── effect.ts
├── index.ts
├── operations.ts
├── reactive.ts
└── ref.ts
简单介绍一下各个文件的内容:
- baseHandlers 和 collectionHandlers — 我们知道 vue 3.0 的响应式是基于 proxy 的,proxy 的用法为
const p = new Proxy(target, handler),这两个文件就是其中第二个参数 handler 的实现。baseHandlers 里实现了代理普通对象,数组的 handler。collectionHandlers 里实现了Map,Set,WeakMap,WeakSet等数据类型的 handler。 - operations — 对于响应式对象的操作类型的枚举声明。
- index.ts — 所有 API 的导出出口。
- 其他 — API 的具体实现。
reactive
介绍
reactive 相关的 API 有四个,分别是 reactive、readonly、shallowReactive、shallowReadonly,这几个 API 的具体用法就不介绍了,可以去看官方文档的介绍。
const obj = { a: 1, b: { c: 2 } }

const proxy = reactive(obj)

// readonly 返回的代理对象不能被修改,
// 否则在 dev 模式下修改的话 console 会有警告。
const proxy2 = readonly(obj)

// 只会代理一层, 修改 proxy3.b.c 是不会被感知到的
const proxy3 = shallowReactive(obj)

console.log(proxy.b) // 惰性代理 obj.b
上面代码中的 obj 有个属性 b 也是一个对象,那么 reactive 在代理 obj 时,不会立即去代理 b,而是会等到访问 b 时,才去惰性代理。readonly 是只读的,它返回的代理对象无法被修改,因此它的值就不会变,也就没有必要做 track,trigger 等响应式追踪处理了。shallowReactive 和 shallowReadonly 则只代理一层,对于嵌套的子对象是不作任何处理的。
另外,这几个 API 都只接受对象参数,number,string,null 等都不接受,会直接返回。
这里再作一个说明,在本文当中,对于 const A = reactive(B),我把 B 称为原始对象,把 A 称为代理对象,我也会把 A 称为响应式对象。
测试用例
接下来,我们来看几个测试用例来了解它们的行为。
// case 1. 对代理对象的修改是会反映到原始对象上的
test('observed value should proxy mutations to original (Object)', () => {
  const original: any = { foo: 1 }
  const observed = reactive(original)
  // set
  observed.bar = 1
  expect(observed.bar).toBe(1)
  expect(original.bar).toBe(1)
})

// case 2. 对同一个原始对象使用 reactive 多次,
// 或者对一个代理对象使用 reactive/readonly,会返回同一个代理对象
test('observing the same value multiple times should return same Proxy', () => {
  const original = { foo: 1 }
  const observed = reactive(original)
  const observed2 = reactive(original)
  expect(observed2).toBe(observed)
})
test('observing already observed value should return same Proxy', () => {
  const original = { foo: 1 }
  const observed = reactive(original)
  const observed2 = reactive(observed)
  expect(observed2).toBe(observed)
})
test('wrapping already wrapped value should return same Proxy', () => {
  const original = { foo: 1 }
  const wrapped = readonly(original)
  const wrapped2 = readonly(wrapped)
  expect(wrapped2).toBe(wrapped)
})

// case 3. 对一个 readonly 对象使用 reactive,
// 会直接返回这个 readonly 对象
test('calling reactive on an readonly should return readonly', () => {
  const a = readonly({})
  const b = reactive(a)
  expect(isReadonly(b)).toBe(true)
  // should point to same original
  expect(toRaw(a)).toBe(toRaw(b))
})

// case 4. 对一个响应式对象使用 readonly,能够正常返回 readonly 对象
test('calling readonly on a reactive object should return readonly', () => {
  const a = reactive({})
  const b = readonly(a)
  expect(isReadonly(b)).toBe(true)
  // should point to same original
  expect(toRaw(a)).toBe(toRaw(b))
})

// case 5. 不同于 reactive 可以代理嵌套的对象,
// shallowReactive 只会代理一层
test('should not make non-reactive properties reactive', () => {
  const props = shallowReactive({ n: { foo: 1 } })
  expect(isReactive(props.n)).toBe(false)
})
test('nested reactives', () => {
  const original = {
    nested: {
      foo: 1
    },
    array: [{ bar: 2 }]
  }
  const observed = reactive(original)
  expect(isReactive(observed.nested)).toBe(true)
  expect(isReactive(observed.array)).toBe(true)
  expect(isReactive(observed.array[0])).toBe(true)
})

// case 6
test('toRaw on object using reactive as prototype', () => {
  const original = reactive({})
  const obj = Object.create(original)
  const raw = toRaw(obj)
  expect(raw).toBe(obj)
  expect(raw).not.toBe(toRaw(original))
})
源码
现在,我们开始阅读源码。
function reactive(target: object) {
  // if trying to observe a readonly proxy,
  // return the readonly version.
  // 针对 case 3
  if (target && (target as Target)[ReactiveFlags.IS_READONLY]) {
    return target;
  }
  return createReactiveObject(
    target,
    false,
    mutableHandlers,
    mutableCollectionHandlers
  );
}
export function shallowReactive<T extends object>(target: T): T {
  return createReactiveObject(
    target,
    false,
    shallowReactiveHandlers,
    shallowCollectionHandlers
  )
}
export function readonly<T extends object>(
  target: T
): DeepReadonly<UnwrapNestedRefs<T>> {
  return createReactiveObject(
    target,
    true,
    readonlyHandlers,
    readonlyCollectionHandlers
  )
}
export function shallowReadonly<T extends object>(
  target: T
): Readonly<{ [K in keyof T]: UnwrapNestedRefs<T[K]> }> {
  return createReactiveObject(
    target,
    true,
    shallowReadonlyHandlers,
    readonlyCollectionHandlers
  )
}
上面代码里的 ReactiveFlags.IS_READONLY 我们稍后介绍。
四个 API 都是调用 createReactiveObject,只不过参数不同罢了,所以这个函数是个重点。
createReactiveObject
function createReactiveObject(
  target: Target,
  isReadonly: boolean,
  baseHandlers: ProxyHandler<any>,
  collectionHandlers: ProxyHandler<any>,
) {
  // 也就是说前面说的这个方法只接受对象
  if (!isObject(target)) {
    if (__DEV__) {
      console.warn(`value cannot be made reactive: ${String(target)}`);
    }
    return target;
  }

  // 对应前面的测试用例 case 2
  // 如果 target 已经是个代理对象,
  // 除非它是被 reacive 代理并且此次调用的是 reayonly,
  // 才会继续下面的流程。
  if (
    // 如果为 true, 说明 target 是一个代理对象
    target[ReactiveFlags.RAW] &&
    // 如果此次调用是 readonly() 并且
    // target 是一个 reactive 代理对象(即 case 4),
    // 才继续流程,否则直接 return
    !(isReadonly && target[ReactiveFlags.IS_REACTIVE])
  ) {
    return target;
  }

  // 对应 case 2, 如果原始对象 target 已经被代理过,返回同一个代理对象
  const reactiveFlag = isReadonly
    ? ReactiveFlags.READONLY
    : ReactiveFlags.REACTIVE;
  if (hasOwn(target, reactiveFlag)) {
    return target[reactiveFlag];
  }

  // 有些对象是不可被观察的, 例如 object.frozen
  if (!canObserve(target)) {
    return target;
  }

  // 代理原始对象
  const observed = new Proxy(
    target,
    collectionTypes.has(target.constructor)
      ? collectionHandlers
      : baseHandlers,
  );

  // 将代理对象挂载到原始对象上
  // key 为 ReactiveFlags.READONLY 或 ReactiveFlags.REACTIVE
  def(target, reactiveFlag, observed);
  return observed;
}
ReactiveFlags
接下来我们再来看一下 ReactiveFlags。
export const enum ReactiveFlags {
  // 如果原始对象上带有这个 flag, 那么它将不会被代理
  // 会在上面的 canOvserve 这里检查到被跳过
  SKIP = '__v_skip',

  // 访问代理对象上的这两个 key 时,会在 proxy handlers 里面被拦截
  // 然后返回对应的值,这个后面会提到
  IS_REACTIVE = '__v_isReactive',
  IS_READONLY = '__v_isReadonly',

  // 访问代理对上的这个 key 时,会在 handler 里面拦截,返回原始对象
  RAW = '__v_raw',

  // 前面代码注释里提到,代理对象会通过 Object.def 挂载到原始对象上
  // 挂载时用的 key 就是以下两个
  REACTIVE = '__v_reactive',
  READONLY = '__v_readonly',
}
现在我们再来看一下之前的这段代码
// 对应前面的测试用例 case 2
// 如果 target 已经是个代理对象,
// 除非它是被 reacive 代理并且此次调用的是 reayonly,
// 才会继续下面的流程。
if (
  // 如果为 true, 说明 target 是一个代理对象
  target[ReactiveFlags.RAW] &&
  // 如果此次调用是 readonly() 并且
  // target 是一个 reactive 代理对象(即 case 4),
  // 才继续流程,否则直接 return
  !(isReadonly && target[ReactiveFlags.IS_REACTIVE])
) {
  return target;
}
在这段代码中,访问了 ReactiveFlags.RAW 属性。但是如果 target 是一个代理对象,那么会在 proxy handlers 的 get 方法上拦截这个 flag,返回其原始对象。因此可以通过这个来判断 target 是原始对象还是代理对象。如果 target[ReactiveFlags.RAW] 存在,就说明 target 是一个代理对象。在这种情况下,除非调用的是 readonly(target) 并且这个代理对象 target 是 reactive 的返回的响应式对象(ReactiveFlags.IS_REACTIVE 也会在 proxy handlers 里的 get 里被拦截),否则都会直接 return target 直接返回这个代理对象。
baseHandlers
我们使用 reactive、readonly 等 API 时,最终会调用 createReactiveObject 并且传进去对应的 handlers,最终会在这里使用 Proxy 去代理原始对象。
// 代理原始对象
const observed = new Proxy(
  target,
  collectionTypes.has(target.constructor)
    ? collectionHandlers
    : baseHandlers,
);
接下来,我们就来看下这里 proxy handlers 的实现。
baseHandlers 文件中实现了四种 handlers,分别对应前面四个 API。
const get = /*#__PURE__*/ createGetter();
const shallowGet = /*#__PURE__*/ createGetter(false, true);
const readonlyGet = /*#__PURE__*/ createGetter(true);
const shallowReadonlyGet = /*#__PURE__*/ createGetter(true, true);

export const mutableHandlers = {
  get,
  set,
  deleteProperty,
  has,
  ownKeys
}

export const readonlyHandlers = {
  has,
  ownKeys,
  get: readonlyGet,
  set: () => {
    if (__DEV__) console.warn('xxx')
  },
  deleteProperty: () => {
    if (__DEV__) console.warn('xxx')
  },
}
export const shallowReactiveHandlers = extend({}, mutableHandlers, {
  get: shallowGet,
  set: shallowSet
})
export const shallowReadonlyHandlers = extend({}, readonlyHandlers, {
  get: shallowGet,
})
可以看到,几种 handlers 的区别主要在 get 和 set,并且和前面的 createReactiveObject 类似,主要实现还是在 createGetter 中。
createGetter
function createGetter(isReadonly = false, shallow = false) {
  return function get(target: object, key: string | symbol, receiver: object) {
    // 这里 ReactiveFlags 的拦截前面已经提到过了
    if (key === ReactiveFlags.IS_REACTIVE) {
      return !isReadonly;
    } else if (key === ReactiveFlags.IS_READONLY) {
      return isReadonly;
    } else if (
      // 前面提到的, 如果访问 ReactiveFlags.RAW 会返回原始对象本身
      // 因为代理对象会通过 def 挂载在原始对象上
      // 这里和 receiver 作了个判断,目的应该是处理前面 case 6
      // a.prototype = reactive(obj); a[ReactiveFlags.RAW] 这样的 edge case
      key === ReactiveFlags.RAW &&
      receiver ===
        (isReadonly
          ? (target as any)[ReactiveFlags.READONLY]
          : (target as any)[ReactiveFlags.REACTIVE])
    ) {
      return target;
    }

    const targetIsArray = isArray(target);
    // 当访问 arr.includes 等查找方法时, 需要 track 数组里的每一个元素。
    // arrayInstrumentations 是对 includes 等方法的包装, 这里返回包装过后的方法
    if (targetIsArray && hasOwn(arrayInstrumentations, key)) {
      return Reflect.get(arrayInstrumentations, key, receiver);
    }

    // 这里取到到了要访问的值
    const res = Reflect.get(target, key, receiver);

    // 访问一些特殊的属性,不作任何 track 的处理
    if ((isSymbol(key) ? builtInSymbols.has(key) : key === `__proto__`) ||
        key === `__v_isRef`
    ) {
      return res;
    }

    // 前面提到,如果是 readonly 就不需要 track 了
    // 因为无法修改,那就不会触发响应,也就没有收集依赖的必要了
    // track 后面会介绍
    if (!isReadonly) {
      track(target, TrackOpTypes.GET, key);
    }

    // shallow 只监听一层
    if (shallow) {
      return res;
    }

    // 访问到 ref 会自动解包
    // 如果原始对象是数组的话是不会解包的,这是 by design
    if (isRef(res)) {
      return targetIsArray ? res : res.value;
    }

    // 访问的是一个对象时,惰性代理这个对象
    if (isObject(res)) {
      return isReadonly ? readonly(res) : reactive(res);
    }

    return res;
  };
}
值得注意的是,当调用 arr.includes 等 built-in 的方法时,需要 track 数组里的每一个元素。很好理解,因为底层肯定是遍历了一遍数组嘛。arrayInstrumentations 是对 includes 等方法的包装,在代理对象上访问时实际上返回的是这里的包装方法,所以是有一些性能损失的。
const arrayInstrumentations: Record<string, Function> = {}
;['includes', 'indexOf', 'lastIndexOf'].forEach(key => {
  arrayInstrumentations[key] = function(...args: any[]): any {
    const arr = toRaw(this) as any
    for (let i = 0, l = (this as any).length; i < l; i++) {
      track(arr, TrackOpTypes.GET, i + '')
    }
    // we run the method using the original args first (which may be reactive)
    const res = arr[key](...args)
    if (res === -1 || res === false) {
      // if that didn't work, run it again using raw values.
      return arr[key](...args.map(toRaw))
    } else {
      return res
    }
  }
})
createSetter
现在看看 createSetter。
function createSetter(shallow = false) {
  return function set(
    target: object,
    key: string | symbol,
    value: unknown,
    receiver: object
  ): boolean {
    const oldValue = (target as any)[key]
    if (!shallow) {
      value = toRaw(value)
      // 如果要修改的是一个 ref,且新值不是 ref,那么修改 ref.value 就好了
      // e.g.
      // const a = ref(1); const obj = reactive({ a });
      // obj.a = 2 相当于 a.value = 2
      // 当然,这里 obj 如果是 shallowReative({ a }),就不会走到这里来了。
      if (!isArray(target) && isRef(oldValue) && !isRef(value)) {
        oldValue.value = value
        return true
      }
    } else {
      // in shallow mode, objects are set as-is regardless of reactive or not
    }

    const hadKey = hasOwn(target, key)
    // 先修改,再触发响应
    const result = Reflect.set(target, key, value, receiver)
    // don't trigger if target is something up in the prototype chain of original
    if (target === toRaw(receiver)) {
      // trigger 触发响应,后面再介绍
      if (!hadKey) {
        trigger(target, TriggerOpTypes.ADD, key, value)
      } else if (hasChanged(value, oldValue)) {
        trigger(target, TriggerOpTypes.SET, key, value, oldValue)
      }
    }
    return result
  }
}
deleteProperty, has, ownKeys
这几个方法比较简单,放在一起,没什么特别的地方,就不作过多解释了,看看就好。
function deleteProperty(target: object, key: string | symbol): boolean {
  const hadKey = hasOwn(target, key)
  const oldValue = (target as any)[key]
  const result = Reflect.deleteProperty(target, key)
  if (result && hadKey) {
    trigger(target, TriggerOpTypes.DELETE, key, undefined, oldValue)
  }
  return result
}
function has(target: object, key: string | symbol): boolean {
  const result = Reflect.has(target, key)
  if (!isSymbol(key) || !builtInSymbols.has(key)) {
    track(target, TrackOpTypes.HAS, key)
  }
  return result
}
function ownKeys(target: object): (string | number | symbol)[] {
  track(target, TrackOpTypes.ITERATE, ITERATE_KEY)
  return Reflect.ownKeys(target)
}
collectionHandlers
collectionHandlers 的逻辑大体类似,只不过对于 Map、Set 等数据类型需要多做一些额外的处理,这里就不多介绍了(主要是懒)。
到这里,一个对象被代理的流程基本上过完了,接下来,我们就来看下 @vue/reactivity 响应式系统是怎么运作的。
响应式从何而来?
const obj = { count: 1 }
console.log(obj.count)
obj.count = 2
想象一下,我们希望在 obj.count 变化的时候,重新执行一下 console.log(obj.count)。很显然,我们没有办法直接告诉 JavaScript 解释器 ——「嘿,v8,你给我重新执行一下第二行的 console.log。」
如果,我将这个 log 放到一个函数里执行,并且在值变化的时候,重新去调用这个函数,那不就行了?(下面改造的这段代码其实有点像 Svelte 做的事情)
const obj = { count: 1 }
log()
setCount(2)

function log() {
  console.log(obj.count)
}

function setCount(v) {
  obj.count = v;
  log()
}
现在,我们通过 setCount 去修改 obj.count,log 会重新执行(这其实就是 React 的模型),符合我们的要求。
但这里有两个问题:
- 所有的更新都需要通过这样一个 set 函数,在有些人看来这并不符合 JavaScript 的直觉。
- 没有依赖收集,当值变化的时候,不知道哪些函数要重新执行。——这里是通过硬编码直接写在
setCount里,在一般的场景下,例如有很多值都会变化,不同值的变化要重新执行的函数都不一样,这种模型下框架无法理解这里面的依赖关系。
我们来看看 Vue 是如何解决这两个问题的。
const obj = reactive({ count: 1})

const reactiveEffect = effect(() => {
  console.log(obj.count)
})

obj.count = 2
第一个问题,利用 Proxy 或者 Object.defineProperty,将显式的 API 调用映射为语法,即赋值语句。
第二个问题,引入了一个 effect 函数,effect 函数接收一个函数 fn 作为参数,这个函数就是值变化时要重新执行的函数,并且返回一个 reactiveEffect。reactiveEffect 是一个函数,直接调用它的话,内部经过一系列处理后会最终会调用传递给 effect(fn) 的 fn,因此下文我会用「副作用函数」来指代 reactiveEffect。
在这里,副作用函数的运行是由 @vue/reactivity 的响应式系统控制的,因此当这个副作用函数运行时,Vue 是知道当前正在执行的是哪个 reactiveEffect。
如果只是做到在值变化的时候重新运行副作用函数,这还不够,我们需要更精确的去运行副作用函数,避免无谓的额外调用(React 就做不到这点,只能重新渲染整个组件),因此需要一个依赖收集的机制,这里的「依赖」指的就是 reactiveEffect 本身。
在副作用函数里访问了响应式对象,当响应式对象更新时,需要重新运行这个副作用函数。
前面说了,副作用函数的执行是由 Vue 的响应式系统控制的,在 effect 里面访问一个响应式对象时,Vue 是知道当前正在执行的是哪个副作用。我们在访问响应式对象时,在 getter 里把当前正在运行的副作用函数收集起来,就能够建立这样的依赖关系。
好了,现在响应式的思路其实就是 —— 当值变化时,我需要重新执行一段逻辑,我就把这段逻辑放到一个函数里面。我需要精确的知道哪一段逻辑需要被重新执行,因此我把这个函数传给 effect,让它可以收集到这个依赖。
所以你在副作用函数以外是收集不到依赖的,也就没有响应式。并且由于只有副作用函数里才能收集到依赖,所以默认情况下,调用 effect(fn) 时会自动运行一次 reactiveEffect 副作用函数去收集依赖(类似 MobX 的 autorun),不然还得手动调一下。
依赖收集和触发响应
现在我们知道了,当依赖变化的时候,触发响应的方式就是依赖它的重新运行一下 effect。依赖收集是在 get 的时候调用一个 track 函数,响应式触发时机就是在 set 的时候调用 trigger 。
在介绍这两个函数之前,我们先来看一下 @vue/reactivity 响应式系统是如何管理依赖,其数据存储结构是什么样的。
依赖的存储方式
// The main WeakMap that stores {target -> key -> dep} connections.
// Conceptually, it's easier to think of a dependency as a Dep class
// which maintains a Set of subscribers, but we simply store them as
// raw Sets to reduce memory overhead.
type Dep = Set<ReactiveEffect>
type KeyToDepMap = Map<any, Dep>
const targetMap = new WeakMap<any, KeyToDepMap>()

export interface ReactiveEffect<T = any> {
  (): T
  _isEffect: true
  id: number
  active: boolean
  raw: () => T
  deps: Array<Dep>
  options: ReactiveEffectOptions
}

export interface ReactiveEffectOptions {
  lazy?: boolean
  scheduler?: (job: ReactiveEffect) => void
  onTrack?: (event: DebuggerEvent) => void
  onTrigger?: (event: DebuggerEvent) => void
  onStop?: () => void
}
当你写下如下代码:
const foo = { a: 1, b: 2 }
const bar = { a: 3 }

const f = reactive(foo)
const b = reactive(bar)
@vue/reactivity 会生成一个这样的数据结构。
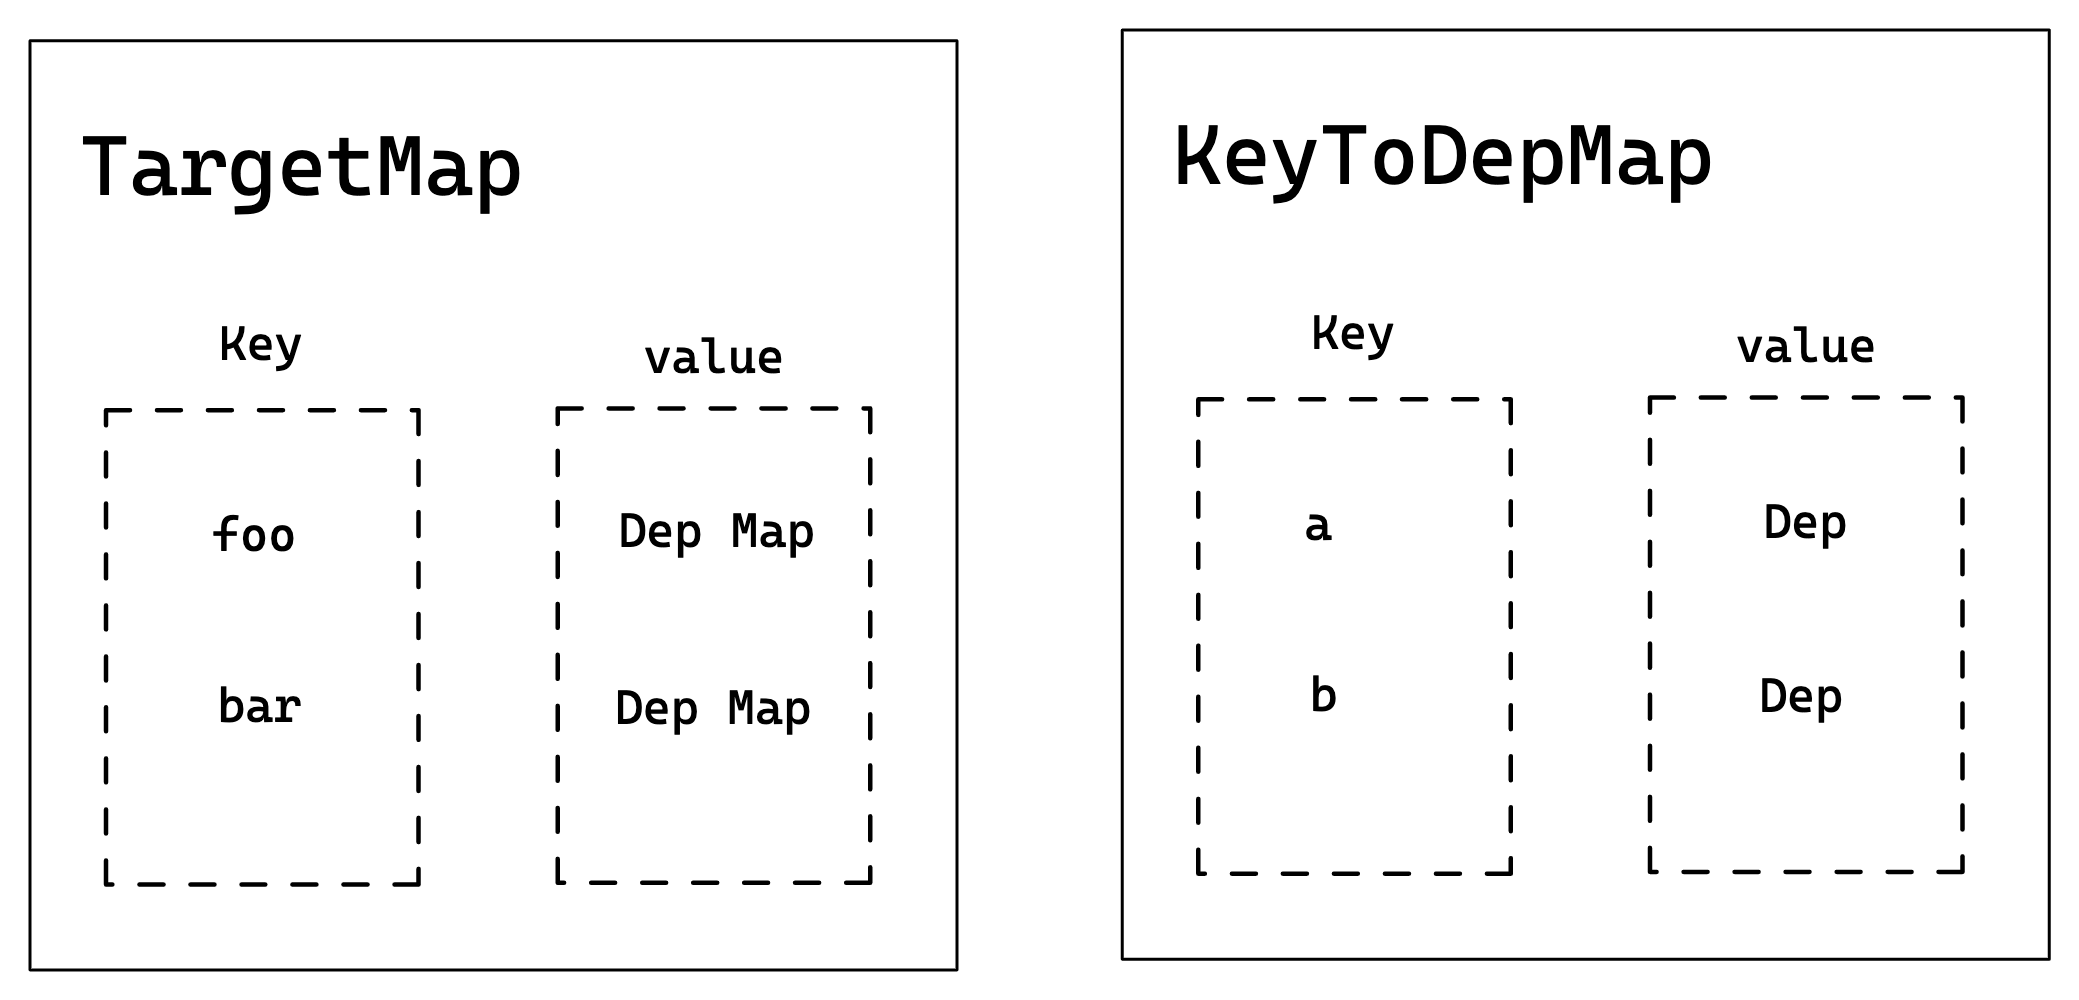
targetMap 是一个 WeakMap,它存储原始对象和 DepMap 的映射关系,DepMap 又是存储原始对象的某个 key 到依赖的映射关系。
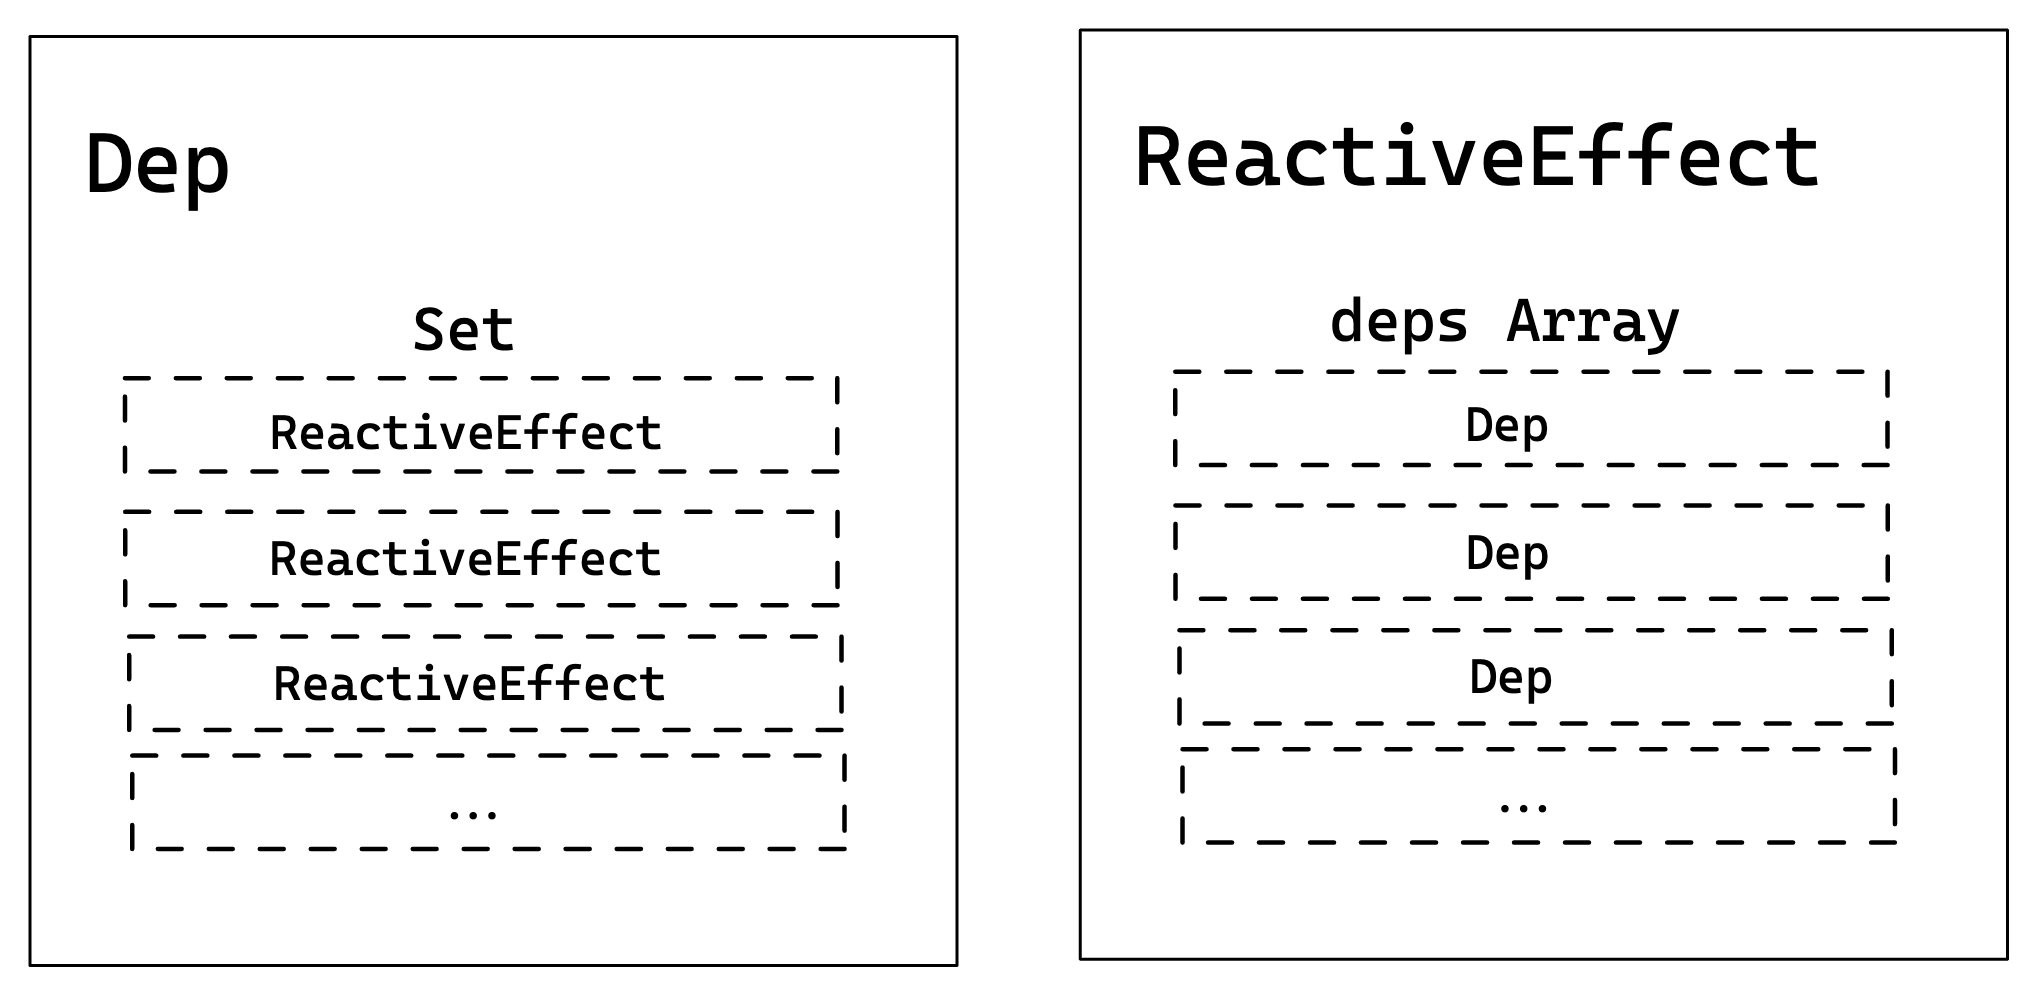
而 Dep 其实是一个 Set 集合,存着的就是 ReactiveEffect,也就是我们前面说的依赖,即 effect 函数调用时返回的东西。同时,ReactiveEffect 上也有一个 deps 属性,它是一个存着 Dep 的数组,也就是说 Dep 和 ReactiveEffect 互相持有对方的引用,它们是一个双向的多对多的关系。
这个也很好理解,请看下面的代码。
const foo = { a: 1, b: 2 }
const bar = { a: 3 }

const f = reactive(foo)
const b = reactive(bar)

const reactiveEffect1 = effect(() => {
  console.log(f.a, b.a)
})
const reactiveEffect2 = effect(() => {
  console.log(f.a)
})

// ------ 以上代码大致会生成下面的结构 ------

// foo.a 的 dep
const dep1 = new Set([reactiveEffect1, reactiveEffect2])
// bar.a 的 dep
const dep2 = new Set([reactiveEffect1])

reactiveEffect1.deps.push(dep1, dep2)
reactiveEffect2.deps.push(dep1)

const fooDepMap = new Map();
const barDepMap = new Map();
fooDepMap.set('a', dep1)
barDepMap.set('a', dep2)

const targetMap = new WeakMap();
targetMap.set(foo, fooDepMap)
targetMap.set(bar, barDepMap)
因为在 reactiveEffect1 里访问了 f.a 和 b.a,因此与它们分别对应的dep1 和 dep2 都会持有 reactiveEffect1。而在 reactiveEffect1 和 reactiveEffect2 当中都访问了 f.a ,因此 f.a 对应的 dep1 会持有 reactiveEffect1 和 reactiveEffect2。
track
理清楚这里依赖的存储方式后,trigger 和 track 的代码理解起来也很容易了,我们先来看看 track 是如何收集依赖的。
我们先回到前面 baseHandlers 的代码里看看 track 是如何调用的
if (!isReadonly) {
  track(target, TrackOpTypes.GET, key);
}
第一个参数是原始对象,第二个参数是 TrackOpTypes.GET,它是一个 enum。最后一个参数 key 就是访问的属性名。
// 这两个 enum 的作用主要是为了标记 track 和 trigger 是由哪种操作导致的
export const enum TrackOpTypes {
  GET = 'get',
  HAS = 'has',
  ITERATE = 'iterate'
}

export const enum TriggerOpTypes {
  SET = 'set',
  ADD = 'add',
  DELETE = 'delete',
  CLEAR = 'clear'
}
我们现在来看下 track 函数的定义。
export function track(target: object, type: TrackOpTypes, key: unknown) {
  // @vue/reactivity 提供了 pauseTracking 和 enableTracking 这两个 api
  // 可以用来手动控制依赖追踪,当调用 pauseTracking 后 shouldTrack 会置为 false
  if (!shouldTrack || activeEffect === undefined) {
    return
  }

  // 确保 depsMap 存在
  let depsMap = targetMap.get(target)
  if (!depsMap) {
    targetMap.set(target, (depsMap = new Map()))
  }

  // 确保这个 key 的 dep 存在
  let dep = depsMap.get(key)
  if (!dep) {
    // dep 是个集合,这样确保在同一个属性在同一 ReactiveEffect 里访问多次
    // 不会存储多个 ReactiveEffect,也就不会运行多次 ReactiveEffect
    depsMap.set(key, (dep = new Set()))
  }

  // activeEffect 就是当前正在运行的 ReactiveEffect, 后面会说
  // 这里首次调用的时候,因为没存过这个 effect,所以会建立双向引用的关系
  // 后续再调用的时候就不会进来了
  if (!dep.has(activeEffect)) {
    // 双向引用
    dep.add(activeEffect)
    activeEffect.deps.push(dep)

    // debug hook
    if (__DEV__ && activeEffect.options.onTrack) {
      activeEffect.options.onTrack({
        effect: activeEffect,
        target,
        type,
        key
      })
    }
  }
}
可以看到,其实没有什么特别的逻辑,就是和前面所说的一样构造出存储结构,将依赖存下来。
trigger
我们同样先看下 baseHandlers 里是如何调用 trigger 的。
// don't trigger if target is something up in the prototype chain of original
if (target === toRaw(receiver)) {
  if (!hadKey) {
    trigger(target, TriggerOpTypes.ADD, key, value)
  } else if (hasChanged(value, oldValue)) {
    trigger(target, TriggerOpTypes.SET, key, value, oldValue)
  }
}
前面三个参数和 track 类似,不多做说明,额外将新值 value 和旧值 oldValue 传进去了。
trigger 的代码会相对多一些。
export function trigger(
  target: object,
  type: TriggerOpTypes,
  key?: unknown,
  newValue?: unknown,
  oldValue?: unknown,
  oldTarget?: Map<unknown, unknown> | Set<unknown>
) {
  // 找到对应的 depsMap
  const depsMap = targetMap.get(target)
  if (!depsMap) {
    // never been tracked
    return
  }

  // 声明一个变量存储待会需要重新运行的 ReactiveEffect
  const effects = new Set<ReactiveEffect>()
  // 一个会被复用的工具函数而已
  const add = (effectsToAdd: Set<ReactiveEffect> | undefined) => {
    if (effectsToAdd) {
      effectsToAdd.forEach(effect => effects.add(effect))
    }
  }

  if (type === TriggerOpTypes.CLEAR) {
    // collection being cleared
    // trigger all effects for target
    // 调了 map.clear() 之类的会清空所有的键,
    // 所有 ReactiveEffect 都要重新运行
    depsMap.forEach(add)
  } else if (key === 'length' && isArray(target)) {
    // 修改数组的 length 来截断数组,需要重新运行依赖了 length 属性
    // 和被删除的元素的 ReactiveEffect
    depsMap.forEach((dep, key) => {
      if (key === 'length' || key >= (newValue as number)) {
        add(dep)
      }
    })
  } else {
    // schedule runs for SET | ADD | DELETE
    // 将对应的 ReactiveEffect 存下来,待会要重新运行
    if (key !== void 0) {
      add(depsMap.get(key))
    }

    // also run for iteration key on ADD | DELETE | Map.SET
    // 会导致数组、集合长度变化的操作,需要重新运行相关属性的 ReactiveEffect
    // 相关属性指的是 array.length, map.keys(), map.entries() etc.
    const isAddOrDelete =
      type === TriggerOpTypes.ADD ||
      (type === TriggerOpTypes.DELETE && !isArray(target))
    if (
      isAddOrDelete ||
      (type === TriggerOpTypes.SET && target instanceof Map)
    ) {
      add(depsMap.get(isArray(target) ? 'length' : ITERATE_KEY))
    }
    if (isAddOrDelete && target instanceof Map) {
      add(depsMap.get(MAP_KEY_ITERATE_KEY))
    }
  }

  // 运行 ReactiveEffect 的工具函数
  const run = (effect: ReactiveEffect) => {
    // debug hook
    if (__DEV__ && effect.options.onTrigger) {
      effect.options.onTrigger({
        effect,
        target,
        key,
        type,
        newValue,
        oldValue,
        oldTarget
      })
    }
    // 有些 effect 会有调度器来控制运行,这个后面再说
    if (effect.options.scheduler) {
      effect.options.scheduler(effect)
    } else {
      // 这里面会调用传给 effect(fn) 的 fn
      effect()
    }
  }

    // 前面已经将需要重新运行的 ReactiveEffect 都存到 effect 里了
  // 这里遍历后全都执行一遍
  effects.forEach(run)
}
想必这些应该都不难理解,接下来比较关键的就只剩下一个 effect 函数的实现了。
effect
老规矩,在介绍具体的 effect 实现之前,我们先来看下另外两个东西,activeEffect 和 effectStack。
const effectStack: ReactiveEffect[] = []
let activeEffect: ReactiveEffect | undefined
前面我们说到,副作用函数运行是由 @vue/reactivity 控制的,它知道当前正在运行的是哪个 ReactiveEffect,原因就是在运行 ReactiveEffect 的时候会把 activeEffect 置为它。而 effectStack 则是用来模拟调用栈,会把 activeEffect 记录下来。
看下面的代码。
const foo = reactive({ count: 1, double: 2 })

const re1 = effect(() => {
  foo.double = foo.count * 2
})

const re2 = effect(() => {
  console.log('double:', foo.double)
})

foo.count = 2
我们有 re1 和 re2 两个副作用函数,re1 里访问了 foo.count 并且对 foo.double 有一个赋值操作,re2 只是访问了 foo.double。
我们来理一下这会发生什么。
- 当我们修改
foo.count = 2时,会在 set 里调用trigger,然后re1会重新运行。 - 在这之前会把
re1push 进effectStack里,再将activeEffect设置为re1,然后运行re1。 - 在运行
re1的时候,我们发现foo.double被修改了,此时又会调用trigger,然后re2会重新运行,根据前面的trigger的代码来看,这个过程是同步的。 - 这时候
activeEffect还是re1,我们需要把re2push 到effectStack里,然后再将activeEffect设置为re2,然后运行re2。 re2运行完以后,effectStack需要把re2pop 出来,然后将activeEffect还原成re1。re1运行完以后,effectStack需要把re1pop 出来,然后将activeEffect还原成undefined。
梳理完这个流程,应该对 activeEffect 和 effectStack 的作用就很清楚了,接下来就来看具体的实现。
effect 的实现
export interface ReactiveEffect<T = any> {
  (): T
  _isEffect: true
  id: number
  active: boolean
  raw: () => T // 存储传给 effect 的 fn 参数
  deps: Array<Dep> // 前面说的存储对 Dep 的引用
  options: ReactiveEffectOptions
}

export interface ReactiveEffectOptions {
  lazy?: boolean
  scheduler?: (job: ReactiveEffect) => void
  onTrack?: (event: DebuggerEvent) => void
  onTrigger?: (event: DebuggerEvent) => void
  onStop?: () => void
}

export function effect<T = any>(
  fn: () => T,
  options: ReactiveEffectOptions = EMPTY_OBJ
): ReactiveEffect<T> {
  // 如果传进来的是个 ReactiveEffect, 则使用它原本的 fn 参数
  if (isEffect(fn)) {
    fn = fn.raw
  }

  // 关键逻辑都在这里面
  const effect = createReactiveEffect(fn, options)

  // 前面说的调用完 effect 会自动执行一次
  // 这个行为可以通过 lazy 的选项来控制
  if (!options.lazy) {
    effect()
  }
  return effect
}

function createReactiveEffect<T = any>(
  fn: () => T,
  options: ReactiveEffectOptions
): ReactiveEffect<T> {
  // 我们说的运行 ReactiveEffect, 其实就是调用这个函数
  // 这里面就是真正的运行逻辑了!我们继续
  const effect = function reactiveEffect(): unknown {
    // @vue/reactivity 提供了一个 stop 函数,
    // 用于手动停止某个 ReactiveEffect 的响应
    // stop 函数里会将 effect.active 置为 false
    if (!effect.active) {
      return options.scheduler ? undefined : fn()
    }

    // 如果 effectStack 里没有这个 effect,就会进入
    // 类似调用栈,当 fn 存在递归时,effectStack 就会存在多个相同的 effect
    if (!effectStack.includes(effect)) {
      // 这里会做些清理依赖的操作,cleanup 函数逻辑继续往下看
      cleanup(effect)

      try {
        // 开启依赖追踪,相关逻辑下面介绍
        enableTracking()

        // 前面说的模拟 callStack
        effectStack.push(effect)
        activeEffect = effect

        // 调用传进来的 fn, 执行用户的逻辑
        return fn()
      } finally {
        // 模拟调用栈 pop
        effectStack.pop()
        // 用户如果手动调了 pauseTracking,
        // 由于 enableTracking 修改了这个状态
        // 因此这里需要恢复依赖追踪
        resetTracking()
        activeEffect = effectStack[effectStack.length - 1]
      }
    }
  } as ReactiveEffect
  effect.id = uid++
  effect._isEffect = true
  effect.active = true
  effect.raw = fn
  effect.deps = []
  effect.options = options
  return effect
}

function cleanup(effect: ReactiveEffect) {
  // 之前存的时候是双向引用, effect 的 deps 数组里持有 Dep,
  // Dep 里也持有 effect
  // 因此这里清理的时候也是双向的
  const { deps } = effect
  if (deps.length) {
    for (let i = 0; i < deps.length; i++) {
      deps[i].delete(effect)
    }
    deps.length = 0
  }
}
为什么运行副作用函数时需要清理依赖
大家可能不太理解为什么在运行 ReactiveEffect 时候要把依赖给清理掉,如果依赖清理掉的话,那下次在修改值的时候不就无法响应了吗?
关于这个问题,看下面这个测试用例。
it('should not be triggered by mutating a property, which is used in an inactive branch', () => {
  let dummy
  const obj = reactive({ prop: 'value', run: true })

  const conditionalSpy = jest.fn(() => {
    dummy = obj.run ? obj.prop : 'other'
  })
  effect(conditionalSpy)

  expect(dummy).toBe('value')
  expect(conditionalSpy).toHaveBeenCalledTimes(1)
  obj.run = false
  expect(dummy).toBe('other')
  expect(conditionalSpy).toHaveBeenCalledTimes(2)
  obj.prop = 'value2'
  expect(dummy).toBe('other')
  expect(conditionalSpy).toHaveBeenCalledTimes(2)
})
传给 effect 的 conditionalSpy 当中,如果 obj.run 为 true,那就会访问 obj.prop,然后收集依赖。如果为 false,那就不会访问到 obj.prop,也就不会将依赖收集到 key 为 prop 的 Dep 上。既然没有收集到,那么当 obj.prop 的值变化时,就不应该响应。
因此,看这里的逻辑,当 obj.run = false,副作用函数重新运行,然后将 dummy 赋值为 'other',这时候并没有访问 obj.prop。然后将 obj.prop = 'value2',根据测试用例,conditionalSpy 执行次数和前面一样,还是 2 次。
如果在运行副作用函数时没有把这个依赖给清理掉,虽然 obj.prop 已经没有被使用了,但是修改它的值还是会重新运行副作用。因此当某个值不再被使用时,即使发生变化,也不应该重新运行副作用函数的行为是 by design 的。而在一般的没有这种条件分支场景下,其实是运行副作用函数收集依赖 -> 依赖变更 -> 清理依赖 -> 重新运行副作用函数收集依赖这样循环的流程,因此是不会出现把依赖清理了导致副作用函数无法响应这种情况发生的。
shouldTrack
最后,我们再来看一下 pauseTracking、enableTracking、resetTracking 这几个方法,和 effectStack 非常类似,也是用栈来记录这些状态,作用在前面 effect 的源码注释里也讲了,这里就不作额外说明,看看就好。
let shouldTrack = true
const trackStack: boolean[] = []

export function pauseTracking() {
  trackStack.push(shouldTrack)
  shouldTrack = false
}

export function enableTracking() {
  trackStack.push(shouldTrack)
  shouldTrack = true
}

export function resetTracking() {
  const last = trackStack.pop()
  shouldTrack = last === undefined ? true : last
}
至此,effect 的核心逻辑也差不多梳理完了。
ref
ref 的逻辑很简单,关键的 track 和 trigger 前面也都介绍了,不多作说明,看看就好。
const convert = <T extends unknown>(val: T): T =>
  isObject(val) ? reactive(val) : val

export function ref(value?: unknown) {
  return createRef(value)
}
function createRef(rawValue: unknown, shallow = false) {
  if (isRef(rawValue)) {
    return rawValue
  }
  let value = shallow ? rawValue : convert(rawValue)
  const r = {
    __v_isRef: true,
    get value() {
      track(r, TrackOpTypes.GET, 'value')
      return value
    },
    set value(newVal) {
      if (hasChanged(toRaw(newVal), rawValue)) {
        rawValue = newVal
        value = shallow ? newVal : convert(newVal)
        trigger(r, TriggerOpTypes.SET, 'value', newVal)
      }
    }
  }
  return r
}
computed
前面我们提到调用 effect 后会自动执行一次副作用函数,并且这个行为可以由一个 lazy 的选项来控制,并且如果 ReactiveEffect 上有一个 scheduler 调度器,那么由于依赖变更而需要重新运行时是会由调度器来控制的。
其实从目前来看,lazy 和 scheduler 都是给 comupted 服务的。computed 的特点时只要在需要的时候才会计算,如果没用到的话,是不需要执行的,因此默认的自动运行的行为是不适合 computed 的。
export function computed<T>(
  getterOrOptions: ComputedGetter<T> | WritableComputedOptions<T>
) {
  // 前面这一堆都是参数的处理,computed 除了可以接受 getter 外
  // 还可以接受一个 setter
  let getter: ComputedGetter<T>
  let setter: ComputedSetter<T>

  if (isFunction(getterOrOptions)) {
    getter = getterOrOptions
    setter = __DEV__
      ? () => {
          console.warn('Write operation failed: computed value is readonly')
        }
      : NOOP
  } else {
    getter = getterOrOptions.get
    setter = getterOrOptions.set
  }

  let dirty = true // 通过一个标志位来标记是不是脏值,脏值的话就要重新计算值
  let value: T // 存储值的变量
  let computed: ComputedRef<T> // 返回的 computed

  // 这里创建了一个 ReacttiveEffect,如前面所说,传了 lazy 和 scheduler
  const runner = effect(getter, {
    lazy: true,
    scheduler: () => {
      // 当 computed 的依赖发生变化,trigger 里运行 effect 时就会走到这里来
      // 然后把标记置为 true 表示发生了更新,下次访问 getter 的时候就会重新计算
      // 虽然 effect 的运行是由调度器来控制,但是这里并没有运行 effect
      if (!dirty) {
        dirty = true
        // 这里 trigger,那些依赖 computed 的副作用函数就会被运行
        trigger(computed, TriggerOpTypes.SET, 'value')
      }
    }
  })
  computed = {
    __v_isRef: true,
    [ReactiveFlags.IS_READONLY]:
      isFunction(getterOrOptions) || !getterOrOptions.set,

    // expose effect so computed can be stopped
    effect: runner,
    get value() {
      if (dirty) {
        value = runner()
        dirty = false
      }
      track(computed, TrackOpTypes.GET, 'value')
      return value
    },
    set value(newValue: T) {
      setter(newValue)
    }
  } as any
  return computed
}
我们看下 schedule 里的 trigger(computed, TriggerOpTypes.SET, 'value')。如果这里有副作用函数被运行,那必然是访问了下面的 get,因为依赖是在 get 里收集的嘛。而在 trigger 前面已经把 dirty 置为 true 了,所以 get 里的 runner 会被调用,runner 也就是 ReactiveEffect,因为传给effect 的 fn 实参是getter ,所以 getter 会被重新求值,并更新到 value 变量上,同时继续触发依赖收集。
所以,这里的流程实际上是:更新某个响应式变量 -> 调用 trigger -> 运行 effect.scheduler -> 调用 trigger -> 运行某个依赖了该 computed 的副作用函数 -> 访问 computed 的 get -> 清理依赖并重新运行副作用函数 -> 重新计算新值 -> 重新收集依赖。
至此,v3.0.0-rc.5 版本的 @vue/reactivity 源码已经分析完了。
结语
这篇文章躺在草稿箱里近一年时间,终于趁这个国庆假期给补完了。
这一年的时间当中,@vue/reactivity 的实现也发生了很大的变化,引入了新的 API effectScope ,也由于一个性能优化的改动 将 ReactiveEffect 改用 class 来实现,因此本文分析的源码稍有些过时,但并不影响大家理解它的响应式系统的怎么运作的。
最后再推荐两篇文章:
完。